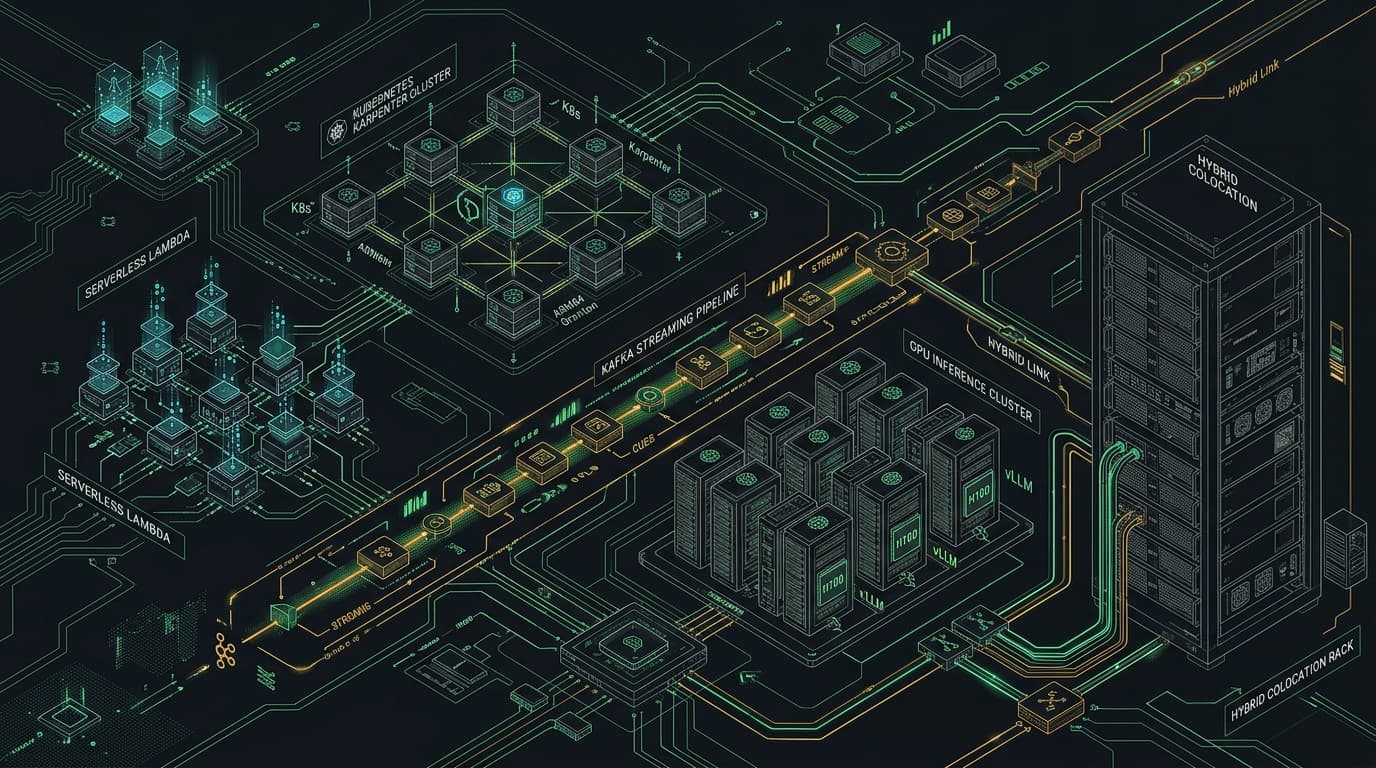
> MİMARİ KATALOĞU // 18 MODEL
18 Bulut Mimarisi ve Başabaş Noktaları
Sunucusuz sistemlerden bare-metal kolokasyona 54 olgunluk seviyesi ve detaylı birim maliyet basamakları.
High-Throughput Streaming: Kafka, Apache Flink & ClickHouse
NVMe diskli Kafka, Apache Flink ve ClickHouse sütunsal veritabanı kullanan, yüksek hacimli gerçek zamanlı analitik ve işlem izleme mimarisi.
Serverless Data Lakehouse on Apache Iceberg & Athena
Apache Iceberg açık tablo formatı, AWS S3 ve sunucusuz sorgu motorları (Athena/DuckDB) kullanan sıfır küme yönetimli veri ambarı mimarisi.
Change Data Capture (CDC) Pipeline: Debezium to Cloud Data Warehouses
Operasyonel veritabanı loglarını (WAL) Debezium ile okuyarak analitik depolara aktaran sürekli veri çoğaltma boru hattı.
TinyCTO Bulut Ekonomisi ve FinOps Mimari Kanonu ('Bulut Faturası İncili'), bulut finansal yönetişimi için operasyonel bir mühendislik disiplini kurar. FinOps Foundation FOCUS 1.0 açık spesifikasyonuna dayanan kanon; 6 arketip altında 18 canlı bulut mimarisini, tespit sorguları ve CLI iyileştirme yönergeleri içeren 24 bulut israfı tipolojisini, malzeme listesi (BOM) hesaplayan belirleyici boyutlandırma sihirbazını, 10 kapsamlı çift dilli mühendislik kılavuzunu ve 26 araçlık karşılaştırma matrisini sunar.
Bulut Mimarisi ve Başabaş Eğrileri Sıkça Sorulan Sorular
Sunucusuz Olay Güdümlü API (Lambda + DynamoDB) ayda 8 milyon isteğin altında neden en ekonomiktir ancak 25 milyonun üzerinde neden dezavantajlıdır?
Sunucusuz mimariler yalnızca çalışma süresi (GB-saniye) ve istek sayısı üzerinden faturalandırılır, bu da dalgalı trafikte sıfır bekleme maliyeti sağlar. Ancak sürekli yüksek hacimde (> 25M istek/ay), milyon istek başına ödenen prim, sabit saatlik ücretle binlerce eşzamanlı isteği karşılayabilen doğru boyutlandırılmış konteynerlerin (ECS Fargate veya Karpenter'lı Kubernetes) maliyetini aşar.
Yüksek Yoğunluklu EKS mimarisi nasıl %82 paketleme (bin-packing) verimliliğine ulaşır?
Karpenter'ın tam zamanında zamanlamasını Graviton ARM64 sunucu havuzları ve Vertical Pod Autoscaler (VPA) öneri motorlarıyla birleştirerek. Pod kaynak talepleri geliştirici tahminleri yerine geçmiş p95 kullanımına göre doğru boyutlandırılır ve Karpenter, bekleyen pod'ların bellek/CPU oranlarına tam uyan sunucu tiplerini seçerek atıl bellek kalmasını engeller.
Yönetilen akış servisleri (Amazon MSK / Confluent) ile kendi sunucunda çalışan ClickHouse / Kafka arasındaki başabaş noktası nedir?
Yönetilen akış servisleri yüksek operasyonel yönetim primi ve yüksek erişilebilirlik alanı veri transfer marjları uygular. Ayda 50 milyon olayın altında yönetilen servisler mühendislik zamanı kazandırır. Ancak ayda 500 milyon olayın üzerinde, S3 katmanlı depolama destekli Kafka ve NVMe üzerinde ClickHouse çalıştırmak, akış ve analitik depolama maliyetlerini %80'in üzerinde düşürerek ayda on binlerce dolar tasarruf sağlar.
Spekülatif Kod Çözme (Speculative Decoding) LLM çıkarım maliyetlerini nasıl 2.2 kat azaltır?
Büyük hedef LLM modelleri (örneğin Llama-3.1-70B), ardışık token üretiminde bellek bant genişliği darboğazına girer. Spekülatif kod çözme, ucuz donanımda çalışan hafif bir taslak modeli (Llama-3.2-1B) devreye sokarak adım başına 4-5 token önerir. Büyük model bu adayları tek bir paralel ileri geçişte doğrular; böylece sıfır doğruluk kaybıyla 2 ila 2.5 kat hızlanma sağlanır ve GPU aktif süresi yarı yarıya iner.
Hibrit Bare-Metal Egress Shield mimarisi bulut bant genişliği bağımlılığını nasıl önler?
Yüksek depolama, video akışı veya veri kopyalama iş yüklerini, Cloudflare veya AWS CloudFront önbelleklerine düşük gecikmeli sınırsız hatla bağlı bare-metal sunucularda (örneğin Hetzner) konumlandırarak. Sabit durum trafiği ücretsiz sınırsız bare-metal hattını kullanırken, genel bulut yalnızca elastik ve durumsuz ani yük patlamalarında tampon olarak devreye girer.
Veritabanı senkronizasyonunda tekrarlayan ETL toplu sorguları yerine neden Debezium CDC tercih edilir?
Periyodik toplu ETL işleri, birincil veritabanı CPU'sunu kilitleyen, okuma IOPS'unu patlatan ve aşırı büyük veritabanı sunucuları gerektiren ağır `SELECT *` taramaları çalıştırır. Debezium Change Data Capture ise veritabanı Write-Ahead Log (WAL) kütüğünü doğrudan depolama motoru düzeyinde sıfıra yakın CPU yüküyle okur ve operasyonel performansı düşürmeden değişiklikleri sürekli akışa dönüştürür.